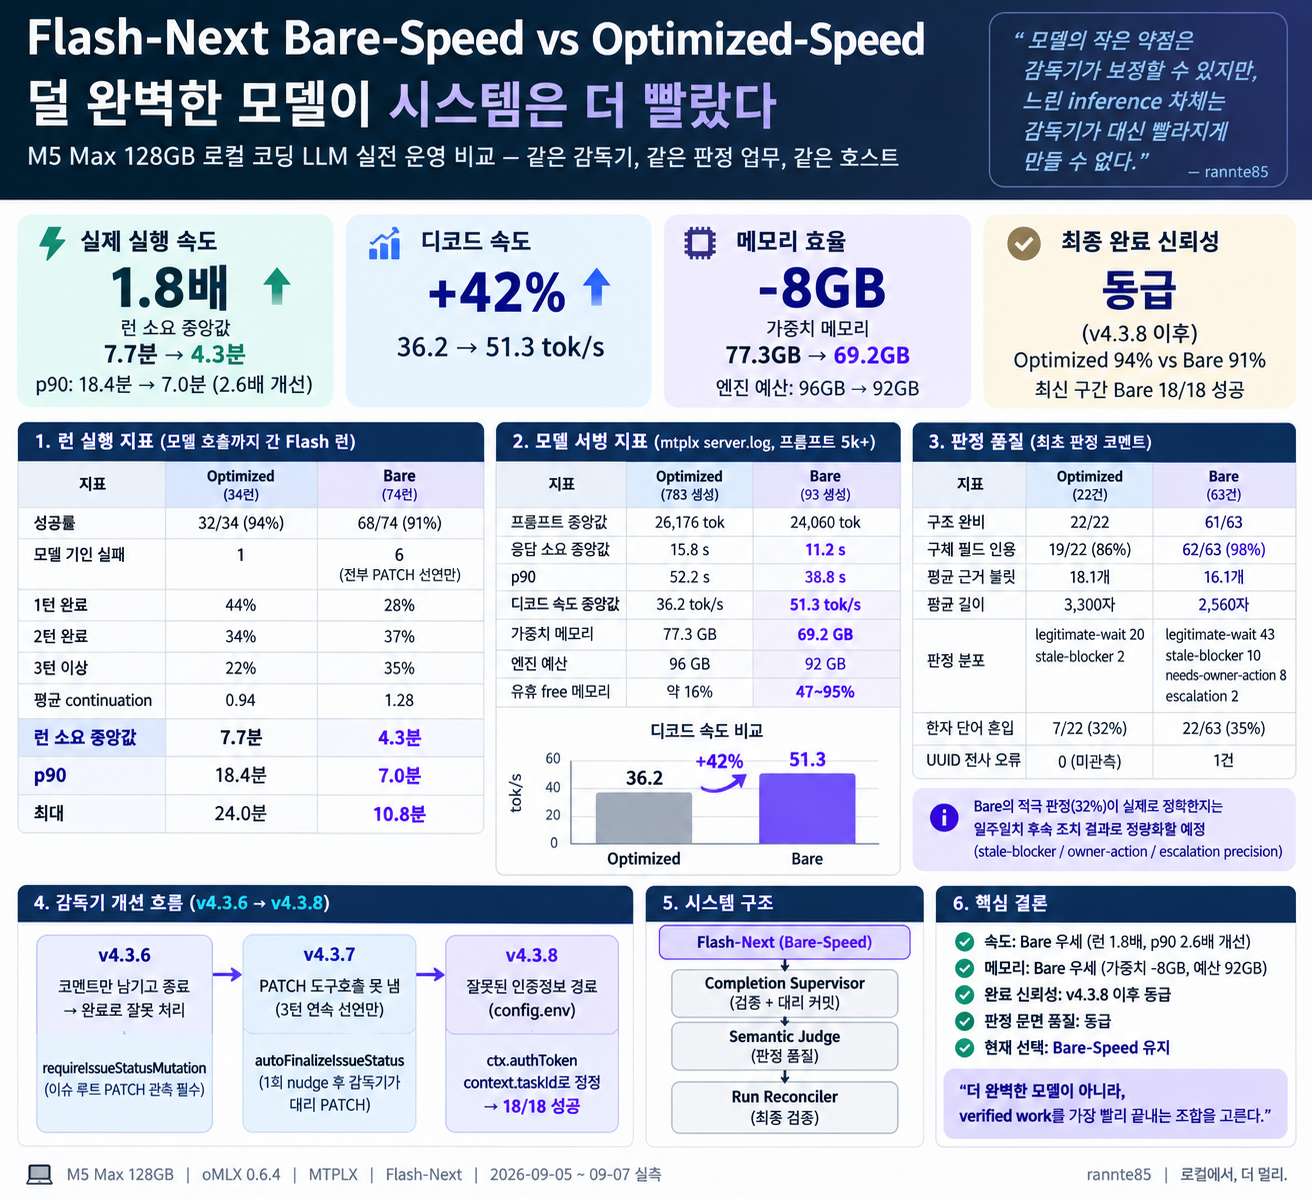
같은 Flash-Next, 같은 M5 Max 128GB, 같은 감독기 계열에서 Bare-Speed와 Optimized-Speed를 실제 운영 기준으로 비교한 결과
이 글은 M5 Max 128GB에서 로컬 코딩 LLM을 실제 에이전트로 운영해보는 시리즈의 4편이다.
앞선 글에서는 oMLX 0.6.4와 MTPLX로 Flash-Next를 더 빠르게 돌려보려다가, 결국 Completion Supervisor, Semantic Checker, Run Reconciler까지 만들게 된 과정을 정리했다.
그때 결론은 꽤 단순했다.
에이전트의 신뢰성은 모델 하나의 능력만으로 결정되지 않는다.
모델이 끝났다고 말한 뒤 시스템이 무엇을 확인하느냐가 중요하다.
이번에는 그 구조를 실제 업무에 더 오래 태우면서, 같은 Flash-Next의 두 실행 설정을 비교했다.
- Optimized-Speed — 조금 더 안정적이고 보수적인 동작
- Bare-Speed — 더 빠르지만 마지막 상태 변경이나 tool call을 빠뜨리는 경향
처음에는 Optimized 쪽이 실제 에이전트 운영에 더 적합할 것이라고 생각했다.
그런데 Completion Supervisor가 발전하면서 결과가 반대로 나왔다.
모델 자체는 Bare가 조금 더 거칠었지만, 시스템 전체로 보면 Bare가 훨씬 빨랐고 최종 완료 신뢰성도 거의 같아졌다.
1. 먼저 결론부터
| 관점 | 결과 |
|---|---|
| 실제 run 속도 | Bare 약 1.8배 우세 |
| p90 지연 | 18.4분 → 7.0분 |
| decode | 36.2 → 51.3 tok/s |
| 모델 메모리 | 약 8GB 절감 |
| 모델 단독 완료 안정성 | Optimized 우세 |
| Supervisor 포함 완료 안정성 | v4.3.8 이후 사실상 동급 |
| 현재 선택 | Bare-Speed 유지 |
이번 비교에서 가장 흥미로웠던 점은 이것이다.
모델 단독으로 더 완벽한 설정이, 전체 시스템에서도 더 좋은 설정은 아니었다.
2. 비교 조건
이번 비교는 가능한 한 같은 조건으로 잡았다.
- 같은 Flash-Next 계열
- 같은 M5 Max 128GB 호스트
- 같은 Reconciler 판정 업무
- 같은 Completion Supervisor 계열
- 감독기 v4.3.1 ~ v4.3.8
재부팅이나 서버 재기동으로 모델 호출 전에 종료된 run은 제외했다.
즉 아래 수치는 실제로 모델 inference까지 들어간 Flash run만 집계했다.
3. Bare는 더 많이 깨워야 했는데, 전체 run은 훨씬 빨랐다
| 지표 | Optimized-Speed | Bare-Speed |
|---|---|---|
| 표본 | 34 runs | 74 runs |
| 성공률 | 32/34 (94%) | 68/74 (91%) |
| 모델 기인 실패 | 1 | 6 |
| 1턴 완료 | 44% | 28% |
| 2턴 완료 | 34% | 37% |
| 3턴 이상 | 22% | 35% |
| 평균 continuation | 0.94 | 1.28 |
| run 중앙값 | 7.7분 | 4.3분 |
| p90 | 18.4분 | 7.0분 |
| 최대 | 24.0분 | 10.8분 |
Bare는 분명 더 많은 continuation을 필요로 했다.
1턴 만에 끝내는 비율도 낮고, 3턴 이상으로 가는 비율도 높다.
모델 단독으로 보면 Optimized가 더 깔끔하게 끝낸다.
그런데 wall-clock은 반대였다.
Optimized 중앙값 7.7분
Bare 중앙값 4.3분
약 1.8배 차이다.
p90은 더 크게 벌어졌다.
18.4분 → 7.0분
꼬리 지연은 약 2.6배 짧아졌다.
Bare는 한두 번 더 깨워야 했지만, 그 추가 비용을 포함해도 전체 ticket 처리 시간은 더 짧았다.
4. Bare의 대표적인 약점 — “PATCH 하겠습니다”라고 말하고 끝난다
Bare-Speed에서 반복적으로 나온 패턴은 꽤 일관됐다.
모델은 판단을 제대로 한다.
Issue에 판정 코멘트도 남긴다.
그리고 마지막에:
이제 상태를 done으로 PATCH하겠습니다.
라고 말한다.
그런데 실제 PATCH tool call은 하지 않고 종료한다.
판단 완료
→ 코멘트 POST
→ "이제 done PATCH 하겠습니다"
→ EOS
이건 이전 글에서 발견했던:
"이제 수정하겠습니다"
→ EOS
와 거의 같은 failure mode다.
모델은 다음에 무엇을 해야 하는지 알고 있다.
다만 마지막 행동 전환에서 끊긴다.
5. Completion Supervisor가 이 약점을 흡수하기 시작했다
Supervisor v4.3.6 이전에는 Issue에 코멘트만 남아도 완료 산출물로 인정될 수 있었다.
그래서 Flash가 판정 코멘트를 남긴 뒤:
done PATCH를 하겠다.
라고 말만 하고 끝나도 완료 처리되는 문제가 있었다.
이를 막기 위해:
requireIssueStatusMutation을 추가했다.
이제는 코멘트가 있는지만 보는 것이 아니라 실제 issue root 상태 mutation이 관측됐는지까지 확인한다.
그러자 Bare의 약점이 명확하게 드러났다.
세 턴 연속:
PATCH 하겠습니다.
라고 선언하면서 실제 PATCH를 호출하지 않는 run도 나왔다.
6. 마지막 기계적 PATCH를 꼭 모델에게 다시 시켜야 할까?
여기서 질문이 바뀌었다.
모델이 이미:
- 판정을 끝냈고
- 어떤 상태로 바꿔야 하는지 명확하게 적었고
- 판정 근거까지 남겼는데
마지막 PATCH tool call만 빠뜨렸다면, 그 마지막 한 단계를 또 모델에게 시킬 이유가 있는가?
그래서 v4.3.7에:
autoFinalizeIssueStatus를 추가했다.
동작은 다음과 같다.
- 모델이 상태 변경을 선언했지만 실제 mutation이 없음
- Supervisor가 한 번 continuation nudge
- 그래도 PATCH가 없으면
- 이미 검증된 target status를 Supervisor가 대신 PATCH
여기서 Supervisor가 새로운 판단을 하는 것은 아니다.
모델의 semantic decision과 마지막 mechanical commit을 분리한 것이다.
7. v4.3.8 이후 Bare의 초기 약점은 사실상 사라졌다
v4.3.7의 첫 구현도 한 번 실패했다.
대리 PATCH용 credential을 잘못된 위치에서 찾고 있었다.
실제 runtime에서는:
ctx.authToken
context.taskId
형태로 값이 전달되고 있었다.
v4.3.8에서 실제 runtime context에 맞게 수정한 뒤, run 6563778c에서 autoFinalize가 실제로 발동했다.
결과는:
HTTP 200
Flash 소유 issue가 정상적으로 done 처리됐다.
그 이후 최신 구간에서는:
Bare-Speed 18/18 성공
을 기록했다.
초기 Bare의 모델 기인 실패 6건은 모두 “마지막 PATCH를 선언만 하고 종료”하는 유형이었고, v4.3.8 이후에는 최종 실패로 이어지지 않았다.
8. 모델 서버 자체도 Bare가 확실히 빨랐다
MTPLX server log에서 prompt 5K 이상인 생성만 따로 모았다.
| 지표 | Optimized | Bare |
|---|---|---|
| 생성 표본 | 783 | 93 |
| prompt 중앙값 | 26,176 tok | 24,060 tok |
| 응답 중앙값 | 15.8초 | 11.2초 |
| p90 | 52.2초 | 38.8초 |
| decode 중앙값 | 36.2 tok/s | 51.3 tok/s |
decode 중앙값은:
36.2 → 51.3 tok/s
약 42% 향상됐다.
그래서 continuation이 조금 늘어도 전체 run이 훨씬 짧았다.
9. 메모리에서도 Bare가 유리했다
| 항목 | Optimized | Bare |
|---|---|---|
| 가중치 | 77.3GB | 69.2GB |
| 엔진 예산 | 96GB | 92GB |
| 유휴 free memory | 약 16% | 47~95% |
Bare는 weight만 약 8GB 작다.
M5 Max 128GB에서 24시간 상주시키는 모델에서는 이 차이가 꽤 중요하다.
실제로 같은 호스트에서:
- Paperclip
- Codex
- Git
- Gradle
- Reconciler
- Flash-Next
가 동시에 움직인다.
이전에는 macOS compressor가 60~70GB까지 성장하고, host watchdog까지 발생한 적이 있었다.
그래서 최고 속도만큼 중요한 것이 24시간 운영하면서 얼마나 많은 headroom을 남기는가였다.
10. Bare가 빠른 대신 판정 품질이 떨어지지는 않았을까?
Flash가 완료한 Reconciler 요청의 최초 판정 코멘트를 따로 비교했다.
| 지표 | Optimized | Bare |
|---|---|---|
| 표본 | 22 | 63 |
| 구조 완비 | 22/22 | 61/63 |
| 구체 field 인용 | 19/22 (86%) | 62/63 (98%) |
| 평균 근거 bullet | 18.1개 | 16.1개 |
| 평균 길이 | 3,300자 | 2,560자 |
현재 표본에서는 Bare가 더 빠른 대신 판단 문면이 크게 열화됐다는 증거는 없었다.
오히려 Bare는:
- 조금 더 짧고
- 구체 field 인용은 더 많고
- 판정 구조는 대부분 유지했다
Reconciler 역할에서는 꽤 좋은 특성이었다.
11. 다만 Bare의 적극 판정은 아직 검증이 필요하다
판정 분포는 꽤 달랐다.
Optimized
- legitimate-wait 20
- stale-blocker 2
Bare
- legitimate-wait 43
- stale-blocker 10
- needs-owner-action 8
- escalation 2
Bare는 약 32%에서 행동 필요 판정을 내렸다.
Optimized보다 훨씬 적극적이다.
하지만 이 차이를 바로 모델의 정확도 차이라고 보기는 어렵다.
두 표본은 측정 시기와 대상 issue 구성이 다르다.
그래서 다음 단계에서는 Flash의 판정 이후 실제 CTO나 owner가 어떤 행동을 했는지를 대조할 예정이다.
- stale-blocker precision
- owner-action precision
- escalation precision
- 전체 action precision
Reconciler는 정상적인 ticket을 괜히 건드리지 않는 것이 중요하기 때문에 recall보다 precision을 우선해서 볼 생각이다.
12. 문자 혼입 문제는 Bare 특유의 결함이 아니었다
초기에는 Bare에서 한국어/일본어 사이에 한자나 다른 문자가 섞이는 현상이 더 많다고 생각했다.
표본을 다시 비교하면:
- Optimized: 7/22, 32%
- Bare: 22/63, 35%
거의 차이가 없었다.
즉 이 문제는 Bare 특유의 문제라기보다 Flash-Next 계열의 공통 출력 습관에 가까웠다.
그래서 현재는 모델을 바꾸기보다:
- ID는 앞 8자리만 출력
- 한/일 외 문자 금지
같은 표기 규칙을 prompt에 포함해서 대응하고 있다.
13. 이번 비교에서 가장 중요한 결론
처음에는 이렇게 생각했다.
Optimized가 더 안정적이니
실제 agent에서는 Optimized가 당연히 더 좋지 않을까?
모델 단독으로 보면 어느 정도 맞았다.
Optimized는 한 번에 일을 끝내는 비율이 더 높고 continuation도 적었다.
Bare는 마지막 tool call을 빠뜨리는 경우가 더 많았다.
그런데 deterministic supervisor가 그 약점을 흡수하자 결과가 뒤집혔다.
Bare-Speed
더 빠름
더 적은 메모리
조금 더 많은 continuation+
Completion Supervisor
마지막 기계적 미완료 회수= 전체 시스템은 더 빠르고, 최종 완료 신뢰성은 거의 같아짐
이 결과를 보고 모델을 고르는 기준 자체가 조금 바뀌었다.
이전에는:
어느 모델 설정이 가장 완벽한가?
를 먼저 봤다.
이제는:
어느 조합이 verified work를 가장 빨리 안정적으로 끝내는가?
를 먼저 본다.
14. 모델의 작은 약점은 Supervisor가 보정할 수 있지만, 느린 inference는 보정하기 어렵다
이번 비교를 한 문장으로 정리하면 이렇다.
모델의 작은 behavioral weakness는 supervisor가 비교적 싸게 보정할 수 있다.
하지만 느린 inference 자체는 supervisor가 대신 빨라지게 만들 수 없다.
Bare는 model-only 기준으로 Optimized보다 조금 거칠었다.
하지만 그 약점은 상당 부분 deterministic supervisor로 복구할 수 있었다.
반대로 Optimized의 36 tok/s를 supervisor가 51 tok/s로 만들어줄 수는 없다.
그래서 현재 Reconciler 판정 업무에서는 Bare-Speed를 유지하고 있다.
15. 현재 판정
| 관점 | 판정 |
|---|---|
| 속도 | Bare 우세 — run 약 1.8배, decode 약 1.4배 |
| p90 | Bare 우세 — 18.4분 → 7.0분 |
| 메모리 | Bare 우세 |
| 모델 단독 완료 안정성 | Optimized 우세 |
| Supervisor 포함 완료 안정성 | v4.3.8 이후 사실상 동급 |
| 판정 문면 | 동급 |
| 현재 운영 선택 | Bare-Speed |
따라서 현재 결론은 다음과 같다.
Bare-Speed는 모델 단독 completion 안정성에서는 조금 불리했다.
하지만 v4.3.8 Supervisor가 그 약점을 흡수한 뒤에는 Optimized와 완료 신뢰성이 사실상 동급이 됐다.
동시에 실제 run은 약 1.8배 빠르고, p90은 2.6배 짧았다.
시스템 전체 기준에서는 Bare-Speed가 더 좋은 선택이었다.
16. 다음 단계
이제 남은 가장 중요한 검증은 Bare의 적극적인 판정이 실제로 정확한가이다.
현재 Flash가 내린:
- stale-blocker
- needs-owner-action
- escalation
판정과 실제 CTO / owner의 후속 행동을 일주일치 outcome으로 대조할 예정이다.
이 precision이 충분히 높다면 Flash-Next는 단순한 coding worker를 넘어:
개발 파이프라인에서 이상 상태를 찾아내고 흐름을 다시 연결하는 로컬 Reconciler
역할까지 꽤 의미 있게 맡길 수 있을 것 같다.
다음 글에서는:
- 적극 판정 false-positive 비율
- CTO overturn 비율
- SonnetReconcilerJudge와의 비교
- orphan run 문제
- M5 Max 호스트 장시간 안정성
까지 묶어서 정리할 예정이다.
17. 시리즈 이전 글
1편 — M5 Max 128GB에서 로컬 코딩 LLM 어디까지 쓸 수 있나
M5 Max 128GB에서 로컬 코딩 LLM 어디까지 쓸 수 있나
2편 — 실제 에이전트로 돌려보니 역할이 완전히 갈렸다
M5 Max 128GB 로컬 코딩 LLM 2편
3편 — oMLX 0.6.4와 MTPLX로 빨라졌는데, 결국 하네스 브릿지를 다시 만들었다
※ 3편 게시 후 이 글의 URL로 교체
LLM Hardtest Report
https://github.com/rannte85/llm-hardtest-report
'AI > LLM' 카테고리의 다른 글
| M5 Max 128GB 로컬 코딩 LLM 5편 — Flash-Next를 실제 Reconciler로 400건 돌려봤다 (0) | 2026.09.10 |
|---|---|
| M5 Max 128GB 로컬 코딩 LLM 3편 — 속도를 올리고 싶었는데, 결국 하네스 브릿지를 다시 만들었다 (0) | 2026.09.03 |
| M5 Max 128GB 로컬 코딩 LLM 2편 — 실제 에이전트로 돌려보니 역할이 완전히 갈렸다 (0) | 2026.08.30 |
| M5 Max 128GB에서 로컬 코딩 LLM 어디까지 쓸 수 있나 (0) | 2026.08.28 |


